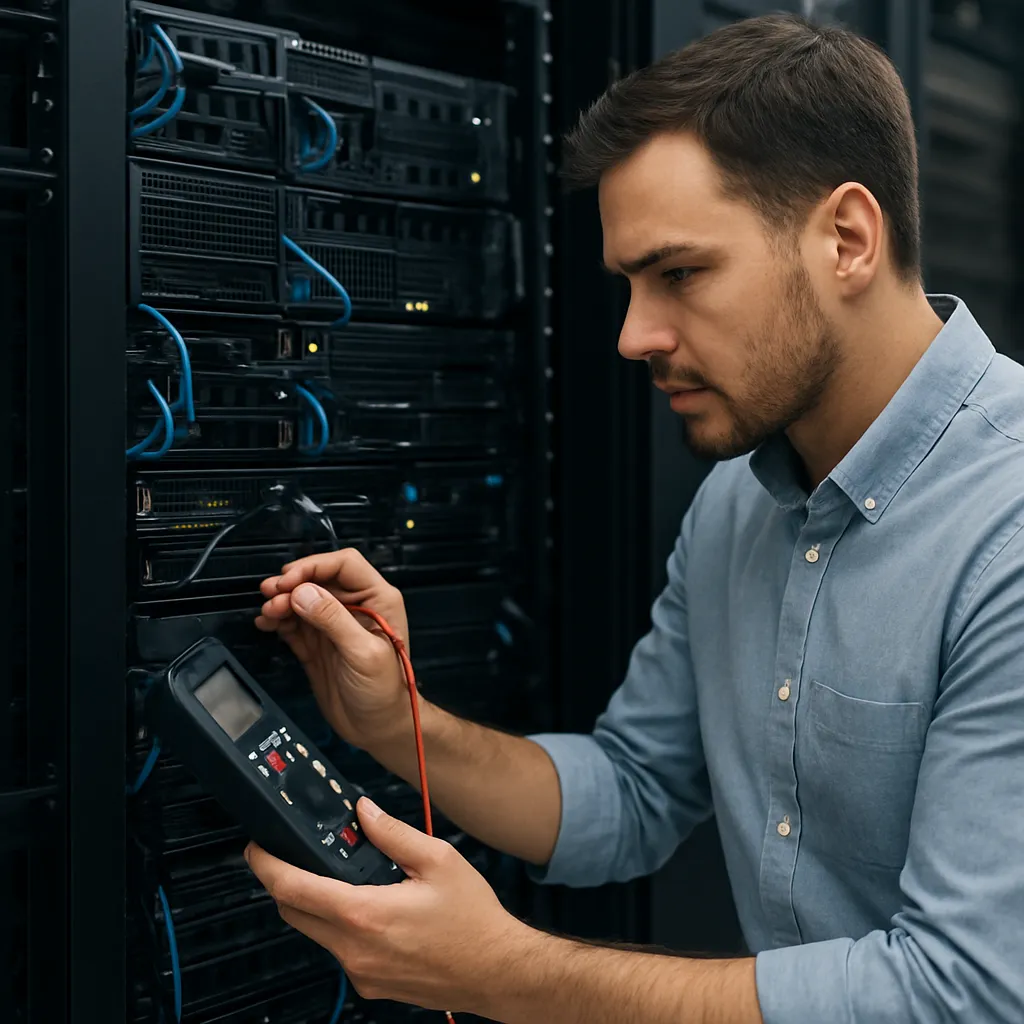
Skuteczna diagnostyka awarii serwera to jeden z kluczowych procesów, który decyduje o ciągłości działania systemów firmowych, bezpieczeństwie danych i komforcie pracy użytkowników. Kiedy serwer przestaje odpowiadać, liczy się szybka reakcja, umiejętne zlokalizowanie źródła problemu oraz dobranie właściwej metody naprawy. To właśnie w tych obszarach zespół IT Crew wspiera swoich klientów, łącząc doświadczenie administracyjne, dobre praktyki branżowe oraz zestandaryzowane procedury reagowania na incydenty. Poniżej znajdziesz omówienie najważniejszych kroków, narzędzi i zasad, które składają się na profesjonalne podejście do diagnozowania awarii serwerów.
Najczęstsze objawy awarii serwera i pierwsze kroki diagnostyczne
Awaria serwera rzadko pojawia się bez jakichkolwiek symptomów. W większości przypadków wcześniejsze sygnały ostrzegawcze można wychwycić na poziomie logów systemowych, wydajności lub komunikatów zgłaszanych przez użytkowników. Kluczem jest umiejętne powiązanie objawów z możliwą przyczyną oraz zastosowanie logicznej ścieżki diagnozy, zamiast chaotycznego testowania kolejnych rozwiązań.
Do najczęstszych objawów świadczących o problemach z serwerem należą:
- Brak dostępu do usług (np. strony www, poczty, systemów ERP) lub bardzo długie czasy odpowiedzi.
- Częste przerwy w działaniu usług, zawieszanie się aplikacji, losowe restarty.
- Komunikaty o braku zasobów, takie jak „brak pamięci”, „brak miejsca na dysku” lub błędy połączeń bazodanowych.
- Alerty z systemów monitoringu dotyczące spadku dostępności, skoków obciążenia CPU czy sieci.
- Niestandardowe wpisy w logach, wskazujące na możliwe naruszenia bezpieczeństwa lub błędy aplikacji.
W początkowym etapie diagnostyki ważne jest, aby:
- Zebrać możliwie pełen obraz sytuacji: jakie usługi nie działają, od kiedy, ilu użytkowników dotyczy problem, czy występuje on stale, czy okresowo.
- Zweryfikować, czy incydent jest lokalny (dotyczy tylko części infrastruktury) czy globalny (brak odpowiedzi całego serwera lub wielu serwerów jednocześnie).
- Ustalić, czy w ostatnim czasie były wykonywane zmiany konfiguracyjne, aktualizacje, migracje czy wdrożenia nowych wersji aplikacji.
IT Crew w swojej codziennej pracy wykorzystuje ustandaryzowane listy kontrolne, które pozwalają szybko zidentyfikować, czy mamy do czynienia z awarią sprzętową, problemem na poziomie systemu operacyjnego, konfiguracji usług, bazy danych, sieci lub warstwy wirtualizacji.
Warstwa sprzętowa i wirtualizacja – fundamenty stabilności serwera
Każda zaawansowana diagnostyka serwera zaczyna się od potwierdzenia poprawnego działania warstwy sprzętowej oraz środowiska wirtualizacji, jeśli jest wykorzystywane. Nawet perfekcyjnie skonfigurowany system operacyjny i aplikacje nie będą działały stabilnie, jeśli problemem jest uszkodzony dysk, przegrzewający się procesor, niestabilny zasilacz czy błędnie pracująca macierz RAID.
Najistotniejsze obszary do weryfikacji na poziomie serwera fizycznego to:
- Stan zasilania – poprawne podłączenie, działanie zasilaczy redundantnych, logi z systemów UPS.
- Temperatury podzespołów – analiza odczytów z czujników sprzętowych (CPU, pamięć, dyski, kontrolery).
- Stan dysków – monitorowanie parametrów SMART, stan macierzy RAID, zgłaszane błędy odczytu/zapisu.
- Pamięć RAM – potencjalne błędy pamięci wykrywane przez system lub narzędzia diagnostyczne.
- Karty sieciowe i interfejsy – poprawne działanie portów, brak błędów transmisji, odpowiednia przepustowość.
W środowiskach wirtualnych, gdzie jeden fizyczny serwer obsługuje wiele maszyn wirtualnych, wymagany jest dodatkowy poziom analizy. Trzeba ustalić, czy awaria dotyczy:
- Hypervisora (np. VMware ESXi, Hyper-V, Proxmox),
- Pojedynczej maszyny wirtualnej,
- Systemu plików, na którym przechowywane są obrazy maszyn,
- Sieci wirtualnej (przełączniki, VLAN-y, reguły ruchu),
- Warstwy storage, jeśli korzystamy z zewnętrznych macierzy lub rozwiązań SAN/NAS.
Specjaliści IT Crew sprawdzają zależności pomiędzy hostami wirtualizacyjnymi, klastrami, storage a maszynami wirtualnymi. To pomaga ustalić, czy awaria ma charakter punktowy, czy dotyczy całej puli zasobów. Dzięki temu można uniknąć pochopnych wniosków, np. przypisywania problemu konkretnej aplikacji, gdy prawdziwą przyczyną jest niestabilna macierz lub błędnie skonfigurowany klaster wysokiej dostępności.
System operacyjny i usługi – od logów do konfiguracji
Kiedy warstwa sprzętowa zostanie zweryfikowana, kolejnym krokiem jest analiza systemu operacyjnego i usług, które na nim działają. To na tym poziomie najczęściej ujawniają się błędy konfiguracji, nieprawidłowe aktualizacje, konflikty między komponentami oraz skutki długotrwałego zaniedbywania porządków w systemie.
Podstawą skutecznej diagnostyki jest praca z logami. W systemach Linux oraz Windows stosowane są różne mechanizmy zbierania i zapisywania dzienników zdarzeń, ale ich rola jest wspólna – dostarczają informacji o błędach, ostrzeżeniach i działaniach podejmowanych przez system i aplikacje.
Na tym etapie specjaliści IT Crew koncentrują się na:
- Analizie dzienników systemowych – poszukiwaniu powtarzających się błędów i ostrzeżeń.
- Weryfikacji stanu usług – które procesy działają, które są zatrzymane, czy występują problemy z ich restartem.
- Sprawdzeniu konfiguracji usług sieciowych – serwerów www, baz danych, serwerów plików, usług katalogowych.
- Analizie ostatnich zmian wprowadzonych do systemu – aktualizacji, instalacji nowych pakietów, modyfikacji konfiguracji.
Niezwykle ważna jest również kontrola wykorzystania zasobów: procesora, pamięci, przestrzeni dyskowej oraz liczby otwartych połączeń sieciowych. Oprogramowanie monitorujące, z którego korzysta IT Crew, agreguje dane historyczne, co pozwala szybko ocenić, czy obecny wzrost obciążenia jest anomalią, czy wynika z przewidywalnego trendu (np. sezonowego wzrostu ruchu).
W praktyce bardzo częstymi przyczynami awarii na tym poziomie są:
- Zapełnione systemy plików, które powodują problemy z działaniem baz danych i usług logowania.
- Nieudane lub niekompletne aktualizacje systemu i aplikacji.
- Błędy konfiguracji usług (np. zmiana portów, błędne ścieżki, nieprawidłowe dane logowania do baz danych).
- Niekontrolowany wzrost liczby procesów lub sesji, skutkujący wyczerpaniem dostępnych zasobów.
Rozpoznanie, czy przyczyną jest pojedynczy proces, nieprawidłowy skrypt startowy, czy błędna polityka automatycznych restartów, wymaga doświadczenia i znajomości typowych wzorców awarii. Dlatego klienci IT Crew korzystają z gotowych metod analizy, przygotowanych na podstawie wieloletniej praktyki w środowiskach produkcyjnych.
Sieć i łączność – kiedy problem leży poza samym serwerem
Zdarza się, że serwer działa poprawnie, ale użytkownicy nadal zgłaszają brak dostępu do usług. W takich przypadkach źródła problemu należy szukać w warstwie sieciowej: konfiguracji routerów, przełączników, firewalli, balancerów ruchu czy usług DNS. Niewłaściwe reguły ruchu, błędy trasowania, przeciążone łącza lub błędne wpisy nazw domenowych potrafią skutecznie zablokować dostęp do poprawnie funkcjonującego systemu.
W procesie diagnostyki sieciowej istotne jest:
- Sprawdzenie podstawowej łączności – testy ping, traceroute, weryfikacja dostępności portów.
- Analiza reguł firewalli i list kontroli dostępu – czy nie wprowadzono blokad na krytyczne usługi.
- Weryfikacja konfiguracji DNS – poprawność rekordów, propagacja zmian, długość TTL.
- Ocena obciążenia łączy i przełączników – występowanie zatorów, błędów transmisji, kolizji.
IT Crew w swojej pracy często spotyka sytuacje, w których przyczyną pozornego „padnięcia serwera” są:
- Zmiany w politykach bezpieczeństwa wprowadzone bez pełnego przetestowania.
- Błędne wpisy DNS po migracjach lub zmianach adresacji IP.
- Częściowe awarie sprzętu sieciowego, które nie powodują pełnego wyłączenia usług, ale znacznie spowalniają działanie.
Profesjonalna diagnostyka uwzględnia więc nie tylko sam serwer, ale i cały ekosystem, w którym funkcjonuje. Pozwala to na wyeliminowanie błędnych założeń i skoncentrowanie się na faktycznym źródle problemu.
Bezpieczeństwo, incydenty i analiza logów pod kątem naruszeń
Szczególną kategorią awarii są te wynikające z problemów bezpieczeństwa. Niekiedy objawiają się one w sposób subtelny: nagłym wzrostem obciążenia, nieuzasadnionym ruchem sieciowym, dziwnymi wpisami w logach lub okresowym brakiem dostępności usług. Innym razem przyjmują postać ataków typu DDoS, prób włamań, złośliwego oprogramowania szyfrującego dane lub przejęcia kont administracyjnych.
W takich sytuacjach diagnostyka musi uwzględniać:
- Szczegółową analizę logów systemowych, logów aplikacyjnych oraz logów urządzeń sieciowych.
- Identyfikację nieautoryzowanych prób logowania i podniesienia uprawnień.
- Weryfikację integralności kluczowych plików systemowych i konfiguracji.
- Sprawdzenie, czy na serwerze nie pojawiły się podejrzane procesy, skrypty lub narzędzia.
Zespół IT Crew podczas obsługi incydentów bezpieczeństwa łączy diagnostykę awarii z analizą śledczą. Celem jest nie tylko przywrócenie działania usług, ale także zrozumienie wektora ataku, skali naruszenia oraz podjęcie działań zapobiegawczych, takich jak zmiana haseł, modyfikacja reguł firewalla, wdrożenie dodatkowych mechanizmów ochronnych czy korekta polityk dostępu.
Specjalistyczne narzędzia typu SIEM oraz centralizacja logów odgrywają tu kluczową rolę. Umożliwiają korelację zdarzeń z wielu źródeł oraz szybkie wyłapanie wzorców mogących wskazywać na złośliwą aktywność. Dzięki temu proces diagnostyczny nie ogranicza się jedynie do stwierdzenia, że serwer nie działa, ale pozwala zrozumieć, czy awaria jest skutkiem celowego działania.
Procedury reagowania, komunikacja i minimalizacja przestojów
Nawet najlepsza technicznie przeprowadzona diagnostyka awarii serwera nie będzie w pełni skuteczna, jeśli zabraknie odpowiednich procedur zarządzania incydentem oraz komunikacji z użytkownikami i interesariuszami biznesowymi. W wielu firmach samo poczucie chaosu i braku informacji wywołuje większe napięcie niż faktyczna skala problemu.
Profesjonalne podejście, stosowane przez IT Crew, obejmuje:
- Jasno zdefiniowane etapy reagowania na incydent – od zgłoszenia, przez klasyfikację, aż po zamknięcie i analizę po zdarzeniu.
- Wyznaczenie osób odpowiedzialnych za koordynację działań technicznych oraz za komunikację z biznesem.
- Dokumentowanie kolejnych kroków, decyzji i zmian wprowadzanych w infrastrukturze w trakcie trwania incydentu.
- Regularne informowanie użytkowników o postępach, przewidywanym czasie usunięcia awarii i ewentualnych obejściach tymczasowych.
Istotnym elementem jest również umiejętność podejmowania decyzji o przełączeniu ruchu na system zapasowy, uruchomieniu środowiska awaryjnego lub wykonaniu przywracania z kopii zapasowych. Tego typu działania wymagają głębokiego zrozumienia architektury systemu, zależności między usługami oraz wpływu poszczególnych decyzji na dane i procesy biznesowe.
Po zakończeniu incydentu warto wykonać analizę przyczynową, aby wyciągnąć wnioski i wprowadzić działania korygujące. IT Crew przygotowuje dla swoich klientów raporty podsumowujące, obejmujące:
- Opis przyczyny awarii i przebieg diagnostyki.
- Podjęte działania naprawcze i ich skuteczność.
- Rekomendacje dotyczące zmian w konfiguracji, bezpieczeństwie lub procesach.
- Propozycje optymalizacji monitoringu i mechanizmów wczesnego ostrzegania.
Rola monitoringu, automatyzacji i dobrych praktyk
Najbardziej efektywna diagnostyka to taka, do której dochodzi jak najrzadziej, ponieważ potencjalne problemy są identyfikowane i eliminowane zanim przerodzą się w poważne awarie. Taki cel przyświeca projektom prowadzonym przez IT Crew – od wdrażania systemów monitoringu, przez automatyzację typowych zadań administracyjnych, aż po standaryzację konfiguracji.
Kluczowe znaczenie mają tu:
- Monitorowanie wydajności – bieżące śledzenie obciążenia CPU, pamięci, dysków, baz danych i usług sieciowych.
- Alertowanie o przekroczeniach progów – automatyczne powiadomienia wysyłane, gdy parametry zbliżają się do wartości krytycznych.
- Testy syntetyczne – symulowanie działania użytkownika, aby sprawdzić, czy usługa jest rzeczywiście dostępna, a nie tylko uruchomiona technicznie.
- Automatyzacja reakcji – skrypty lub narzędzia, które potrafią samodzielnie zrestartować usługę, oczyścić logi czy powiększyć przestrzeń dyskową w określonych sytuacjach.
Wdrożenie dobrych praktyk administracyjnych – takich jak regularne testy przywracania z backupów, cykliczny przegląd logów, aktualizacje zgodnie z ustalonym harmonogramem oraz przegląd uprawnień – znacząco zmniejsza ryzyko poważnych incydentów. Dodatkowo ułatwia późniejszą diagnostykę, ponieważ środowisko jest uporządkowane, a konfiguracje powtarzalne.
IT Crew pomaga klientom zaprojektować architekturę serwerową w sposób wspierający nie tylko wydajność, ale również łatwość diagnozowania problemów. Jasna dokumentacja, spójne nazewnictwo, ujednolicone systemy logowania i centralizacja monitoringu to elementy, które w praktyce skracają czas potrzebny na zlokalizowanie i usunięcie problemu.
Wsparcie IT Crew w diagnostyce awarii serwerów
Diagnostyka awarii serwera to proces wielowymiarowy, wymagający nie tylko znajomości technologii, ale też umiejętności analitycznego myślenia, pracy z logami, rozumienia zależności między systemami oraz doświadczenia w pracy pod presją czasu. Firmy, które nie dysponują własnym zespołem specjalistów, często stają przed trudnym wyborem: czy próbować samodzielnie rozwiązać złożone problemy, czy powierzyć to zadanie zewnętrznemu partnerowi.
IT Crew oferuje klientom kompleksowe wsparcie w tym obszarze, obejmujące:
- Stały nadzór nad serwerami fizycznymi i wirtualnymi oraz kluczowymi usługami biznesowymi.
- Szybką diagnostykę awarii, opartą na ustandaryzowanych procedurach i sprawdzonych narzędziach.
- Rekomendacje zmian w architekturze, konfiguracji i zabezpieczeniach, które zmniejszają ryzyko powtarzających się incydentów.
- Projektowanie i wdrażanie rozwiązań wysokiej dostępności oraz planów ciągłości działania.
Współpraca z doświadczonym zespołem pozwala skoncentrować się na działalności biznesowej, a kwestie techniczne – od monitoringu, przez diagnostykę, po usuwanie awarii – pozostawić specjalistom. Dzięki temu awarie, które kiedyś paraliżowały pracę organizacji, stają się przewidywalnymi incydentami, które można sprawnie opanować i z których wyciąga się wnioski na przyszłość.
Profesjonalna diagnostyka awarii serwera to inwestycja w stabilność środowiska IT, ochronę danych i bezpieczeństwo procesów biznesowych. Odpowiednio zaprojektowane procedury, ciągły nadzór oraz wsparcie kompetentnego partnera, takiego jak IT Crew, pozwalają zamienić nieuniknione problemy techniczne w kontrolowane zdarzenia, które nie zagrażają długoterminowym celom organizacji.